기준은 문서에
규정·운영기준·계약 조건은 문서 저장소에 있습니다. 답의 절반은 그 문서를 찾아 읽는 일입니다.
파일럿은 대부분 성공합니다. 전사로 넓히려는 순간 누가 무엇까지 볼 수 있는가에서 멈춥니다. 권한·민감정보·흩어진 데이터가 한꺼번에 올라오고, 업계가 같은 자리에서 멈추고 있습니다.
AI 에이전트의 행동 능력과 부여된 접근 범위를 구분하지 못할 때 실패가 가장 많이 일어난다. 2027년까지 기업의 40%가 거버넌스 공백 때문에 자율 AI 에이전트를 강등하거나 폐기할 것이다.
2027년까지 데이터 거버넌스의 문화적 과제를 외면한 조직의 60%가 AI를 성공적으로 통제하지 못할 것이다.
정책을 문서로 쓰는 일과, 그 정책이 모든 조회 경로에서 실제로 걸리게 만드는 일은 다릅니다. PAASUP DNA는 뒤쪽을 맡습니다.
세 가지가 각각 다른 도구에 있으면 경로마다 결과가 달라집니다.
사람이든 AI 에이전트든 같은 권한 문을 지납니다. 무엇을 할 수 있는가와 무엇까지 볼 수 있는가를 따로 정합니다.
쓰지 못하게 막는 대신 가린 채로 쓰게 합니다. 정책은 읽는 시점에 걸리고 원본은 손대지 않습니다.
기준은 문서에, 숫자는 DB에 있습니다. 질문하는 사람이 어느 쪽인지 알 필요가 없어야 분석이 일상이 됩니다.
규정·운영기준·계약 조건은 문서 저장소에 있습니다. 답의 절반은 그 문서를 찾아 읽는 일입니다.
지금 몇 명인지, 얼마인지는 데이터베이스에 있습니다. SQL을 아는 사람을 거쳐야 숫자를 받습니다.
개인정보를 가리는 설정이 시스템마다 다르면, 같은 사람이 경로에 따라 다른 값을 보게 됩니다.
문서 저장소·데이터 카탈로그·비식별화 정책이 한 환경에 있습니다. 질문하는 사람은 어느 시스템에 답이 있는지 몰라도 됩니다.
문서·비정형·정형데이터가 한 저장소, 한 카탈로그, 한 질문 창에 있습니다. 질문 하나에 문서와 DB가 함께 답하고 답에는 출처 문서명·페이지와 실행한 SQL이 붙습니다.
개인정보는 한 번 정한 정책대로 읽는 순간 가려집니다. 문서 질의와 SQL 결과에 같은 정책이 걸리고 원본은 손대지 않습니다.
열람·검색·SQL·ETL 어느 경로든 같은 권한 문을 지납니다. 권한이 다른 두 사람이 같은 질의를 실행하면 가려지는 값이 다릅니다.
데모 테넌트에서 촬영한 실제 화면입니다. 사람 정보는 모두 가상 값입니다.
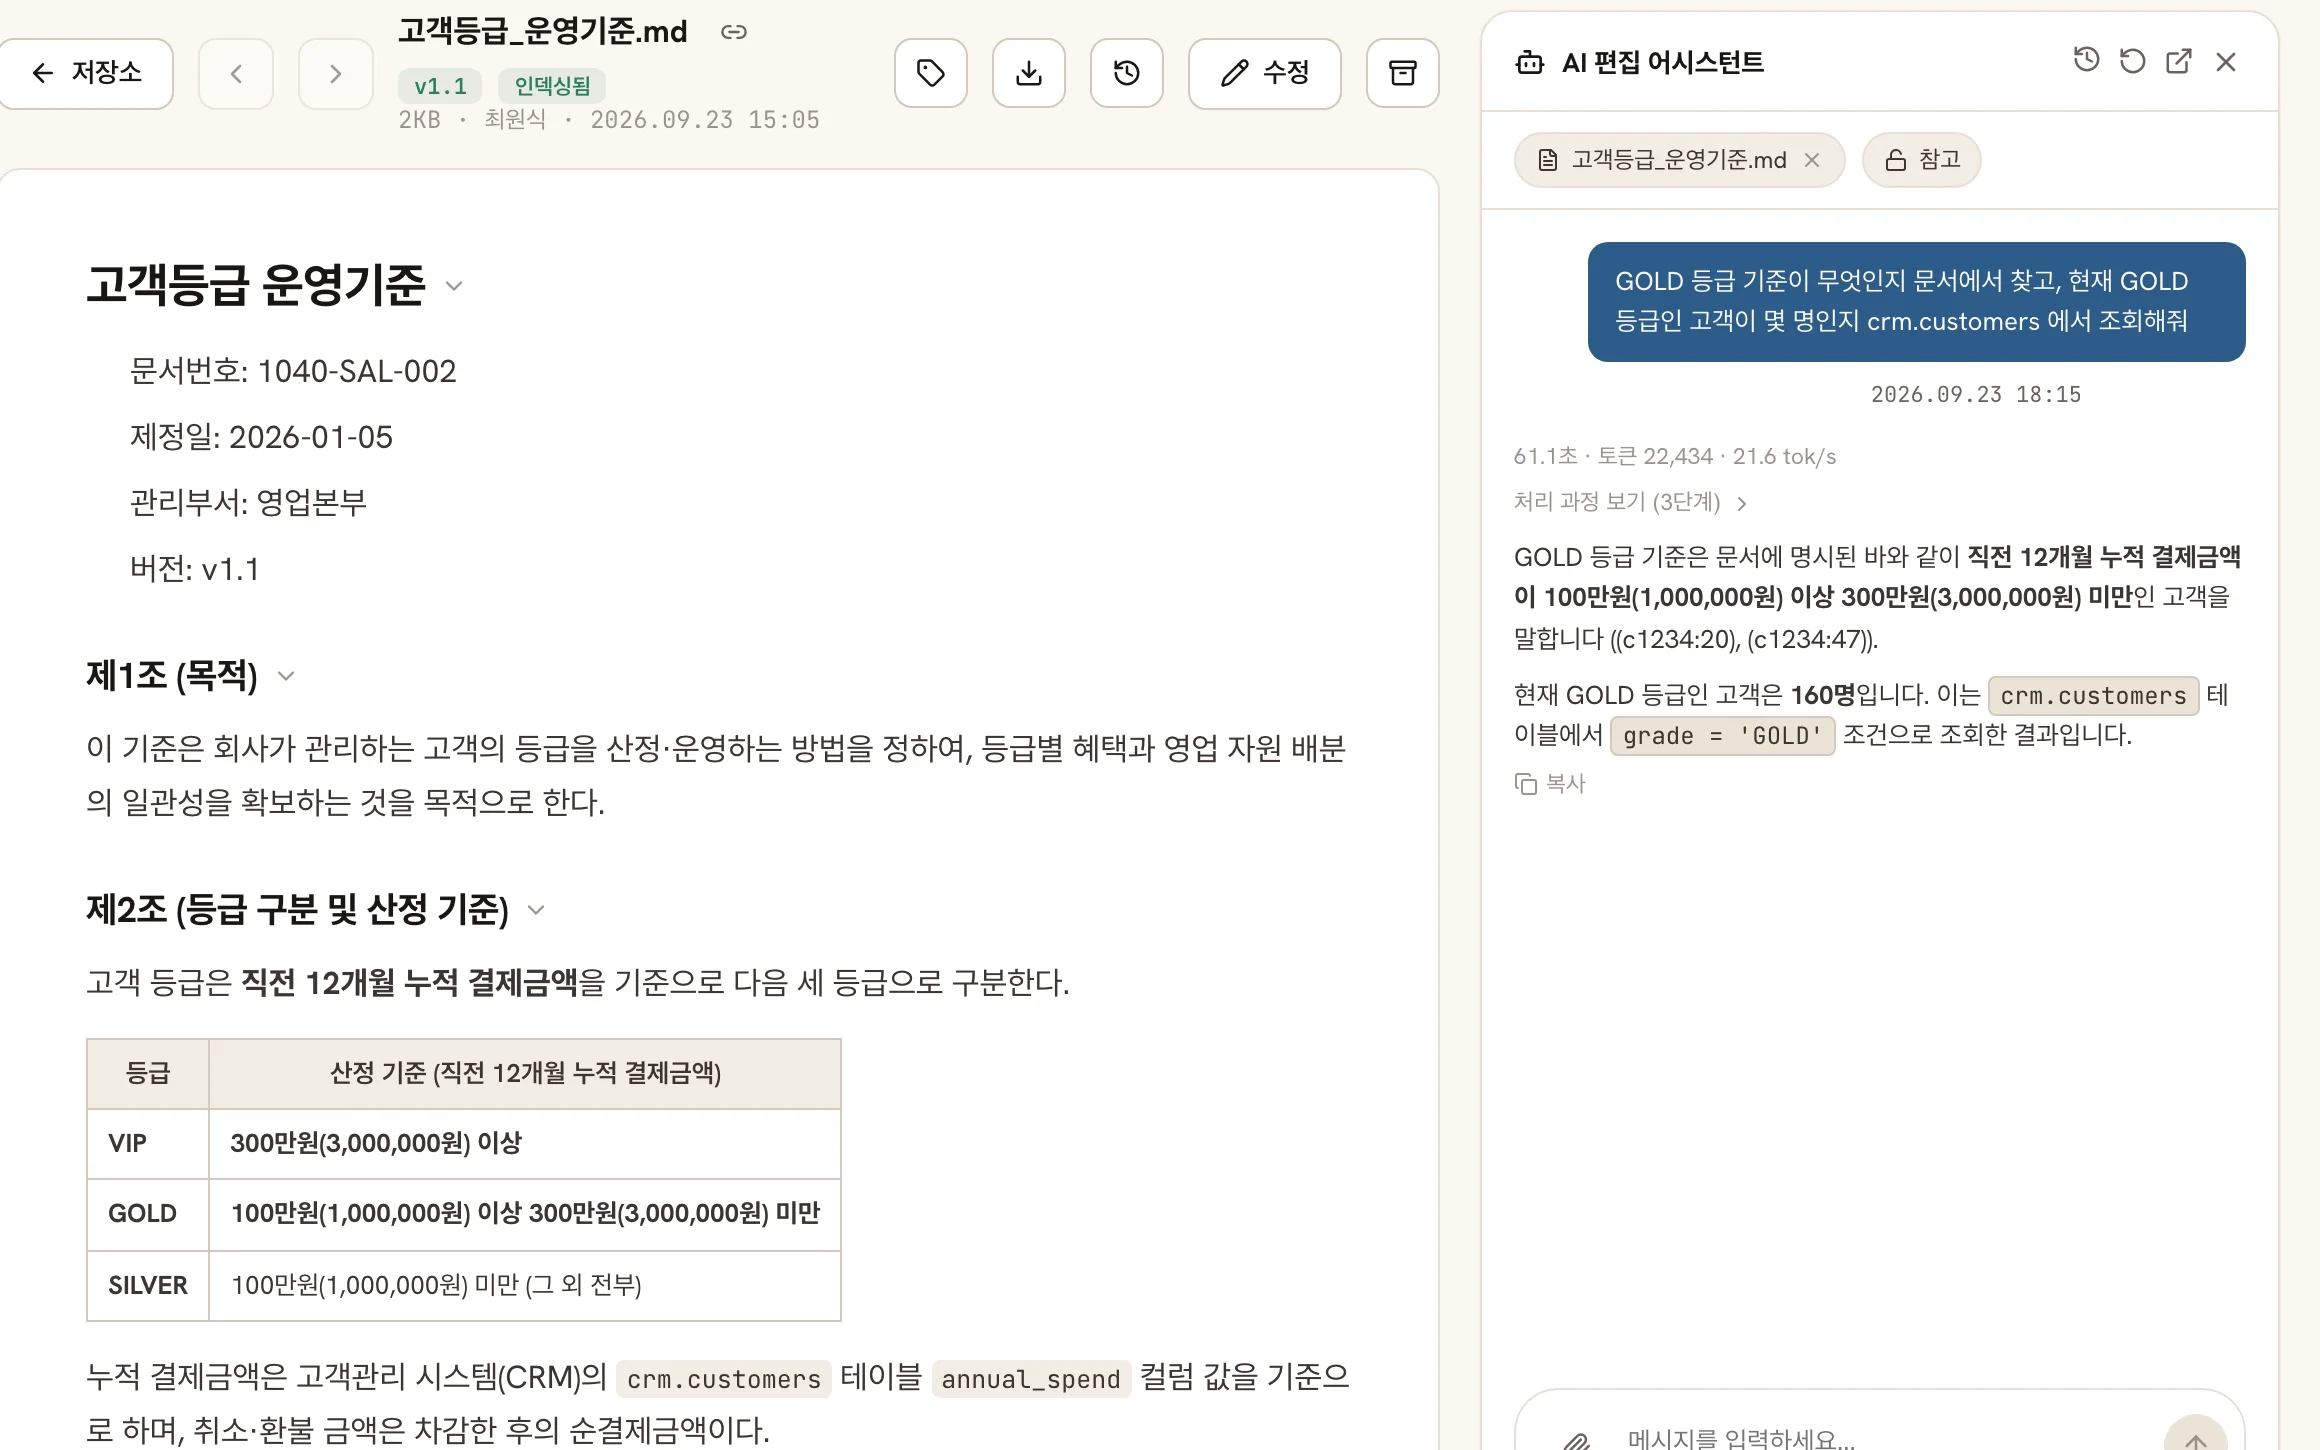
기준은 문서에서, 현재 수치는 테이블에서. 답 하나에 출처 문서명·페이지와 실행한 SQL이 함께 붙습니다.
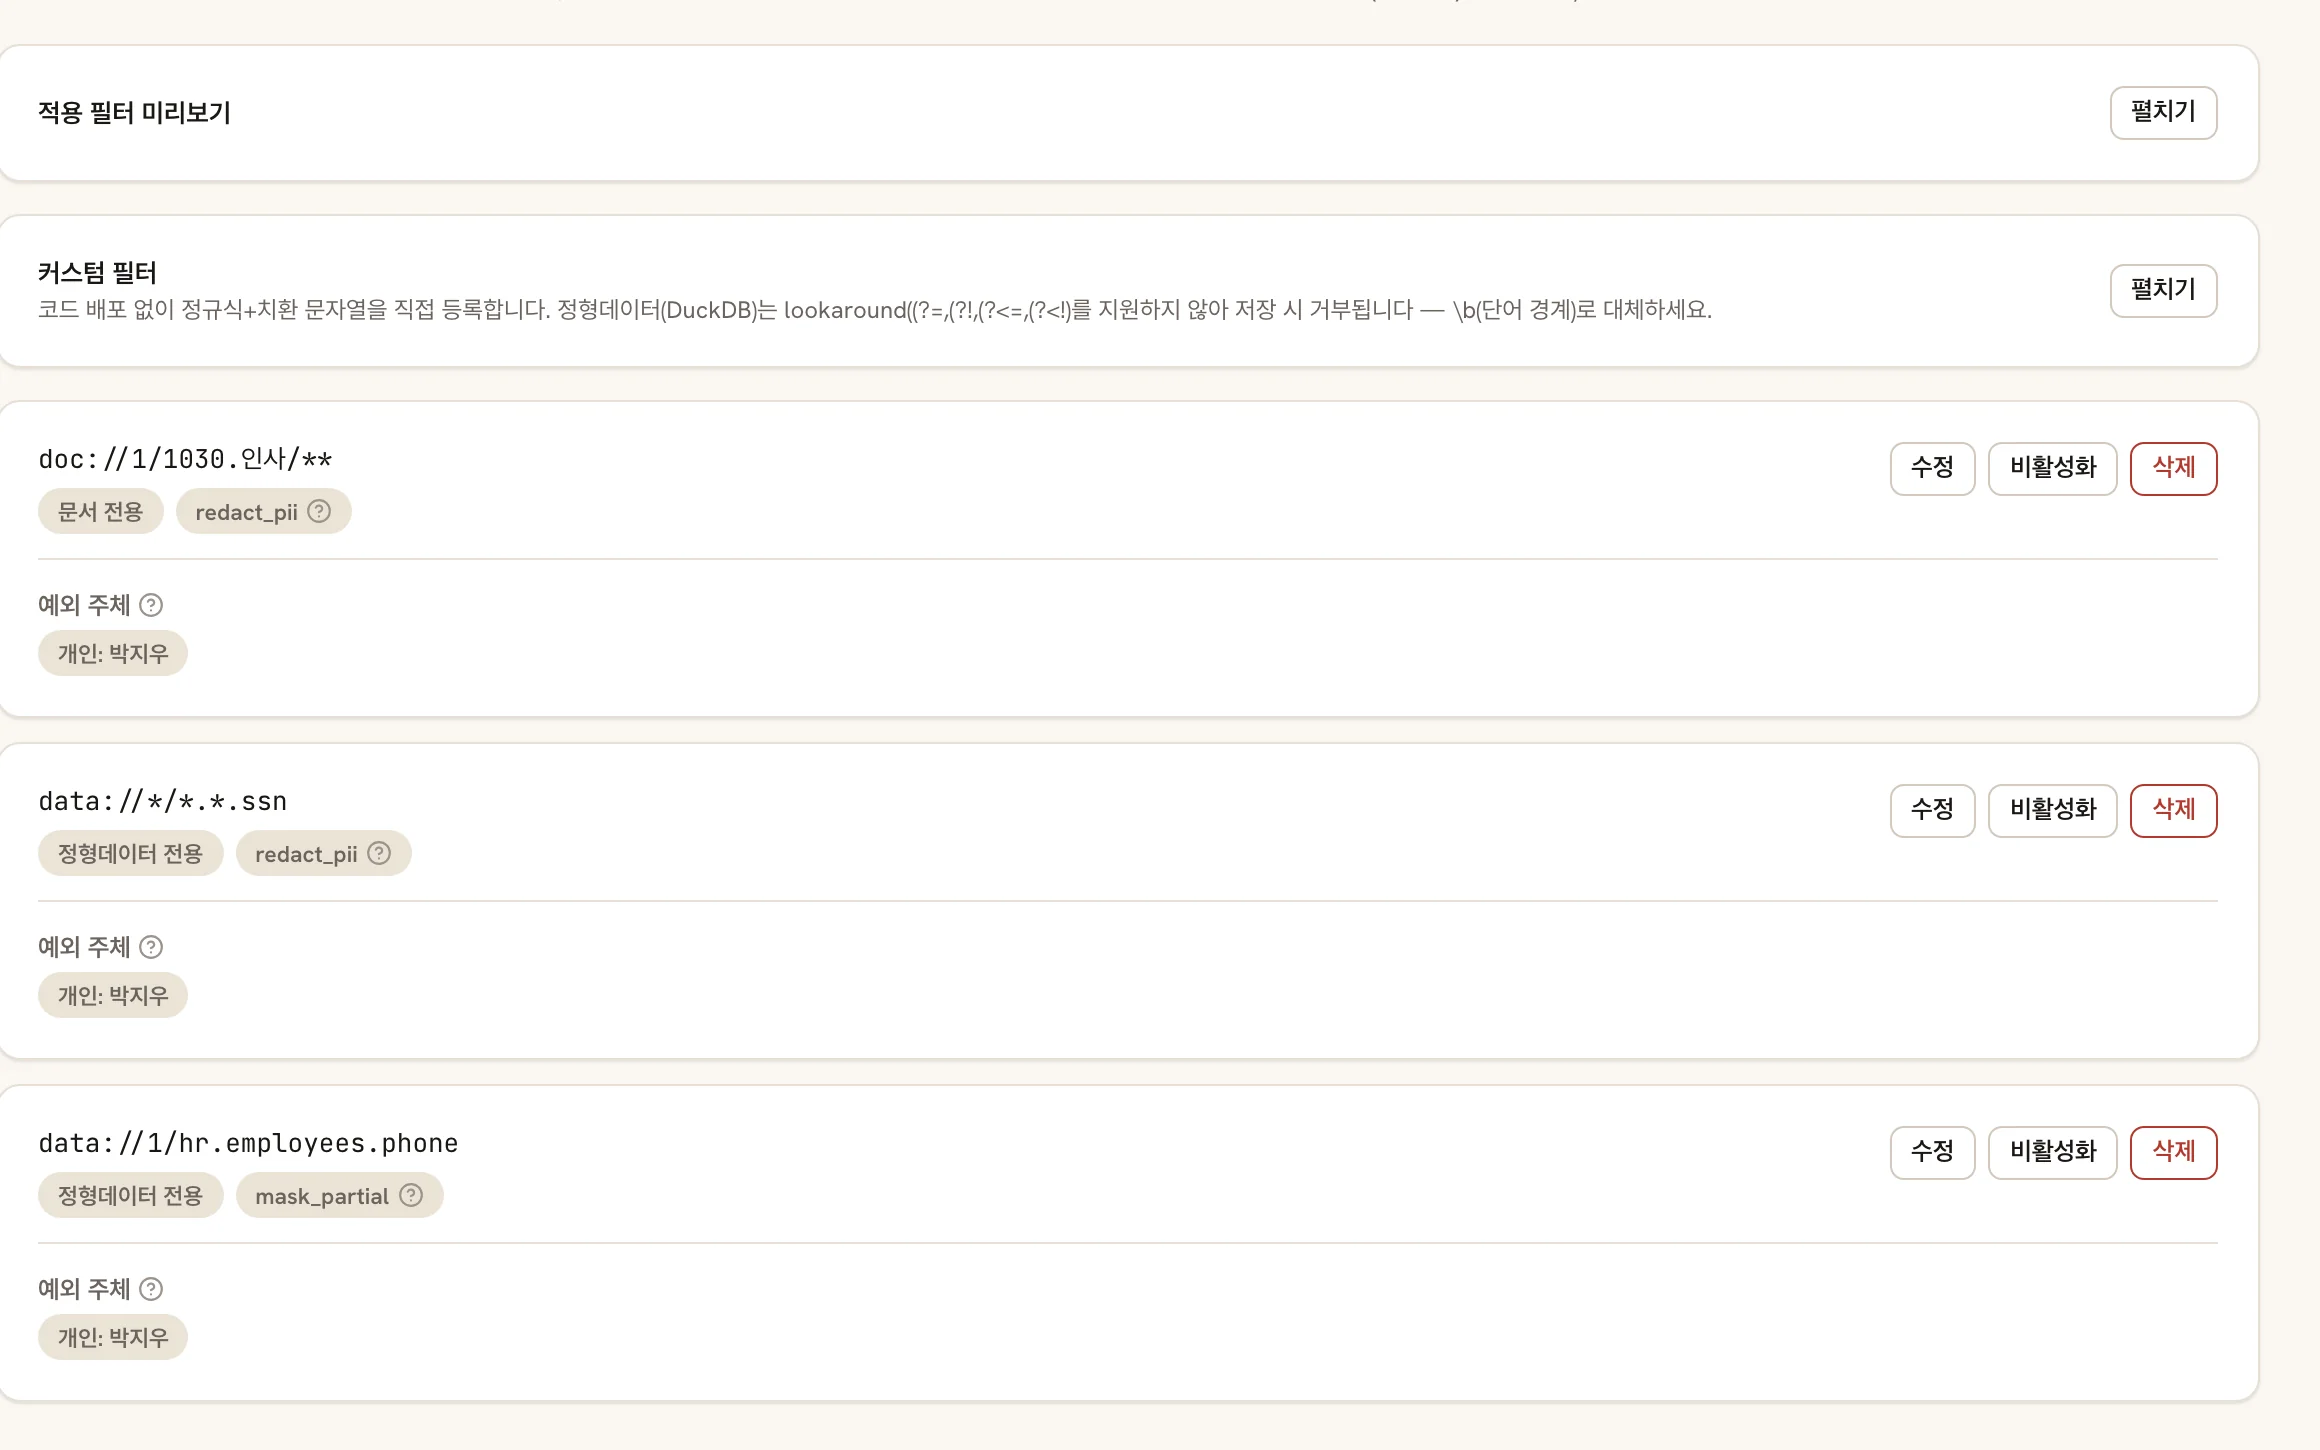
doc:// 문서 경로와 data:// 테이블 컬럼에 같은 비식별화 정책이 걸립니다. 예외 주체는 명시한 사람만입니다. 예외 주체가 아니면 마스킹된 값만 보입니다.
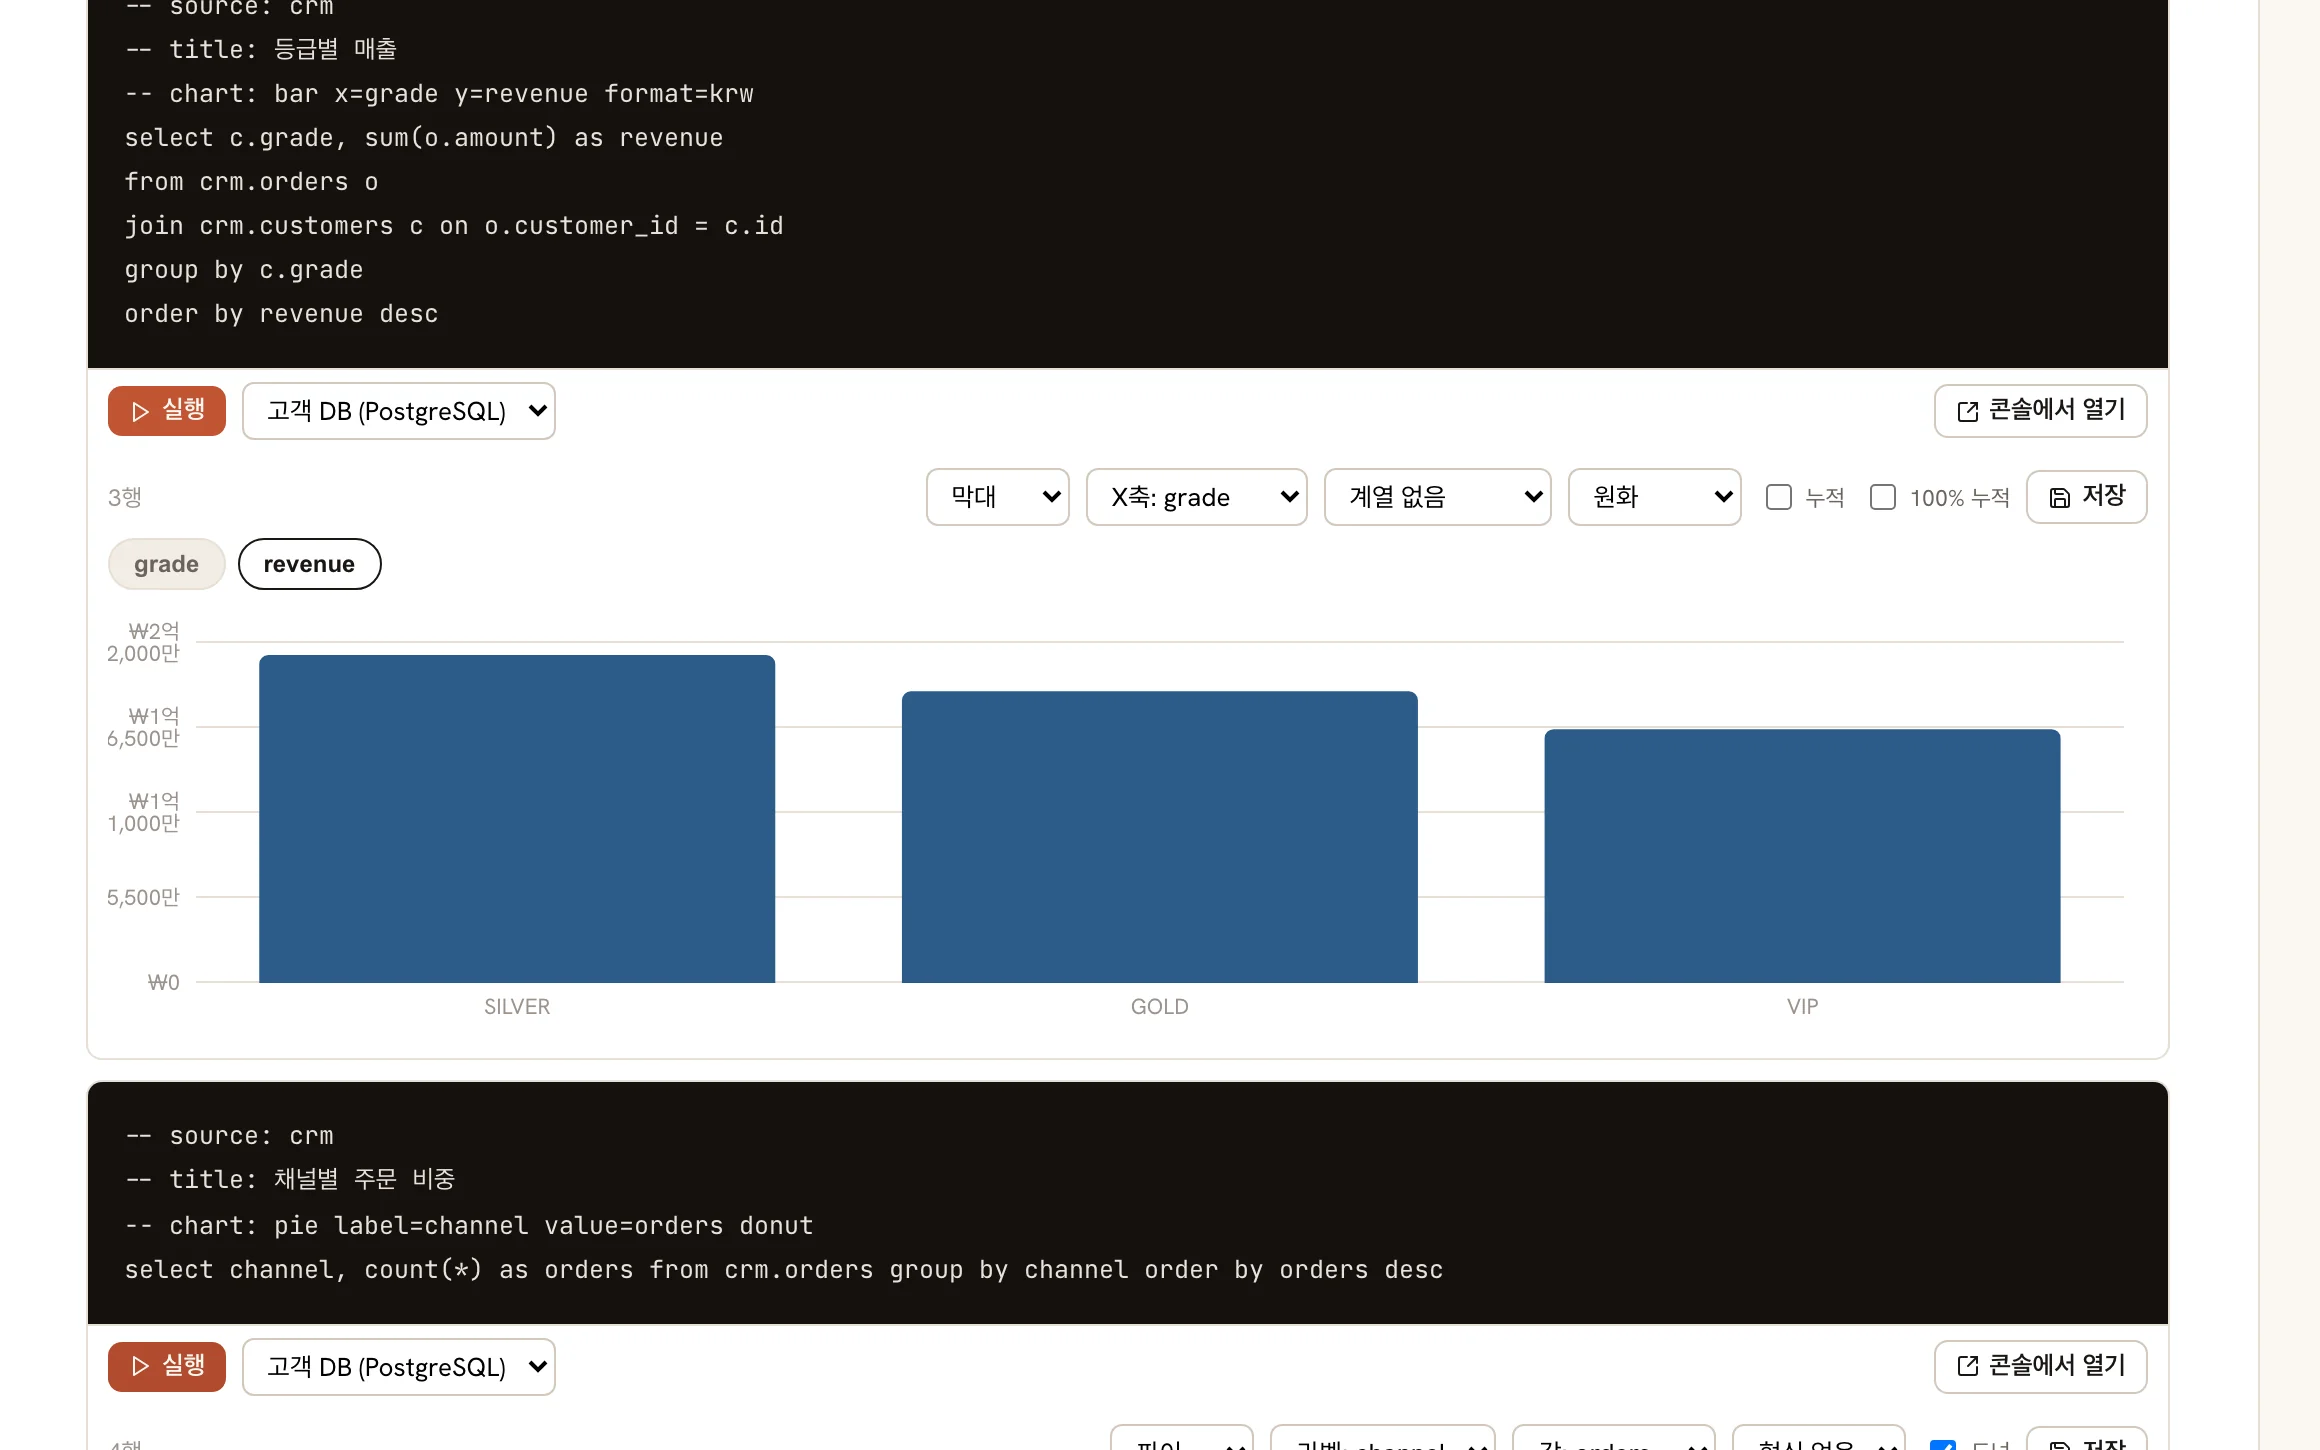
문서 하나에 SQL 셀을 여러 개 두고 각기 다른 차트(선·막대·파이)로 결과를 확인합니다. 셀마다 차트 종류를 바꿔가며 시험해 볼 수 있습니다.
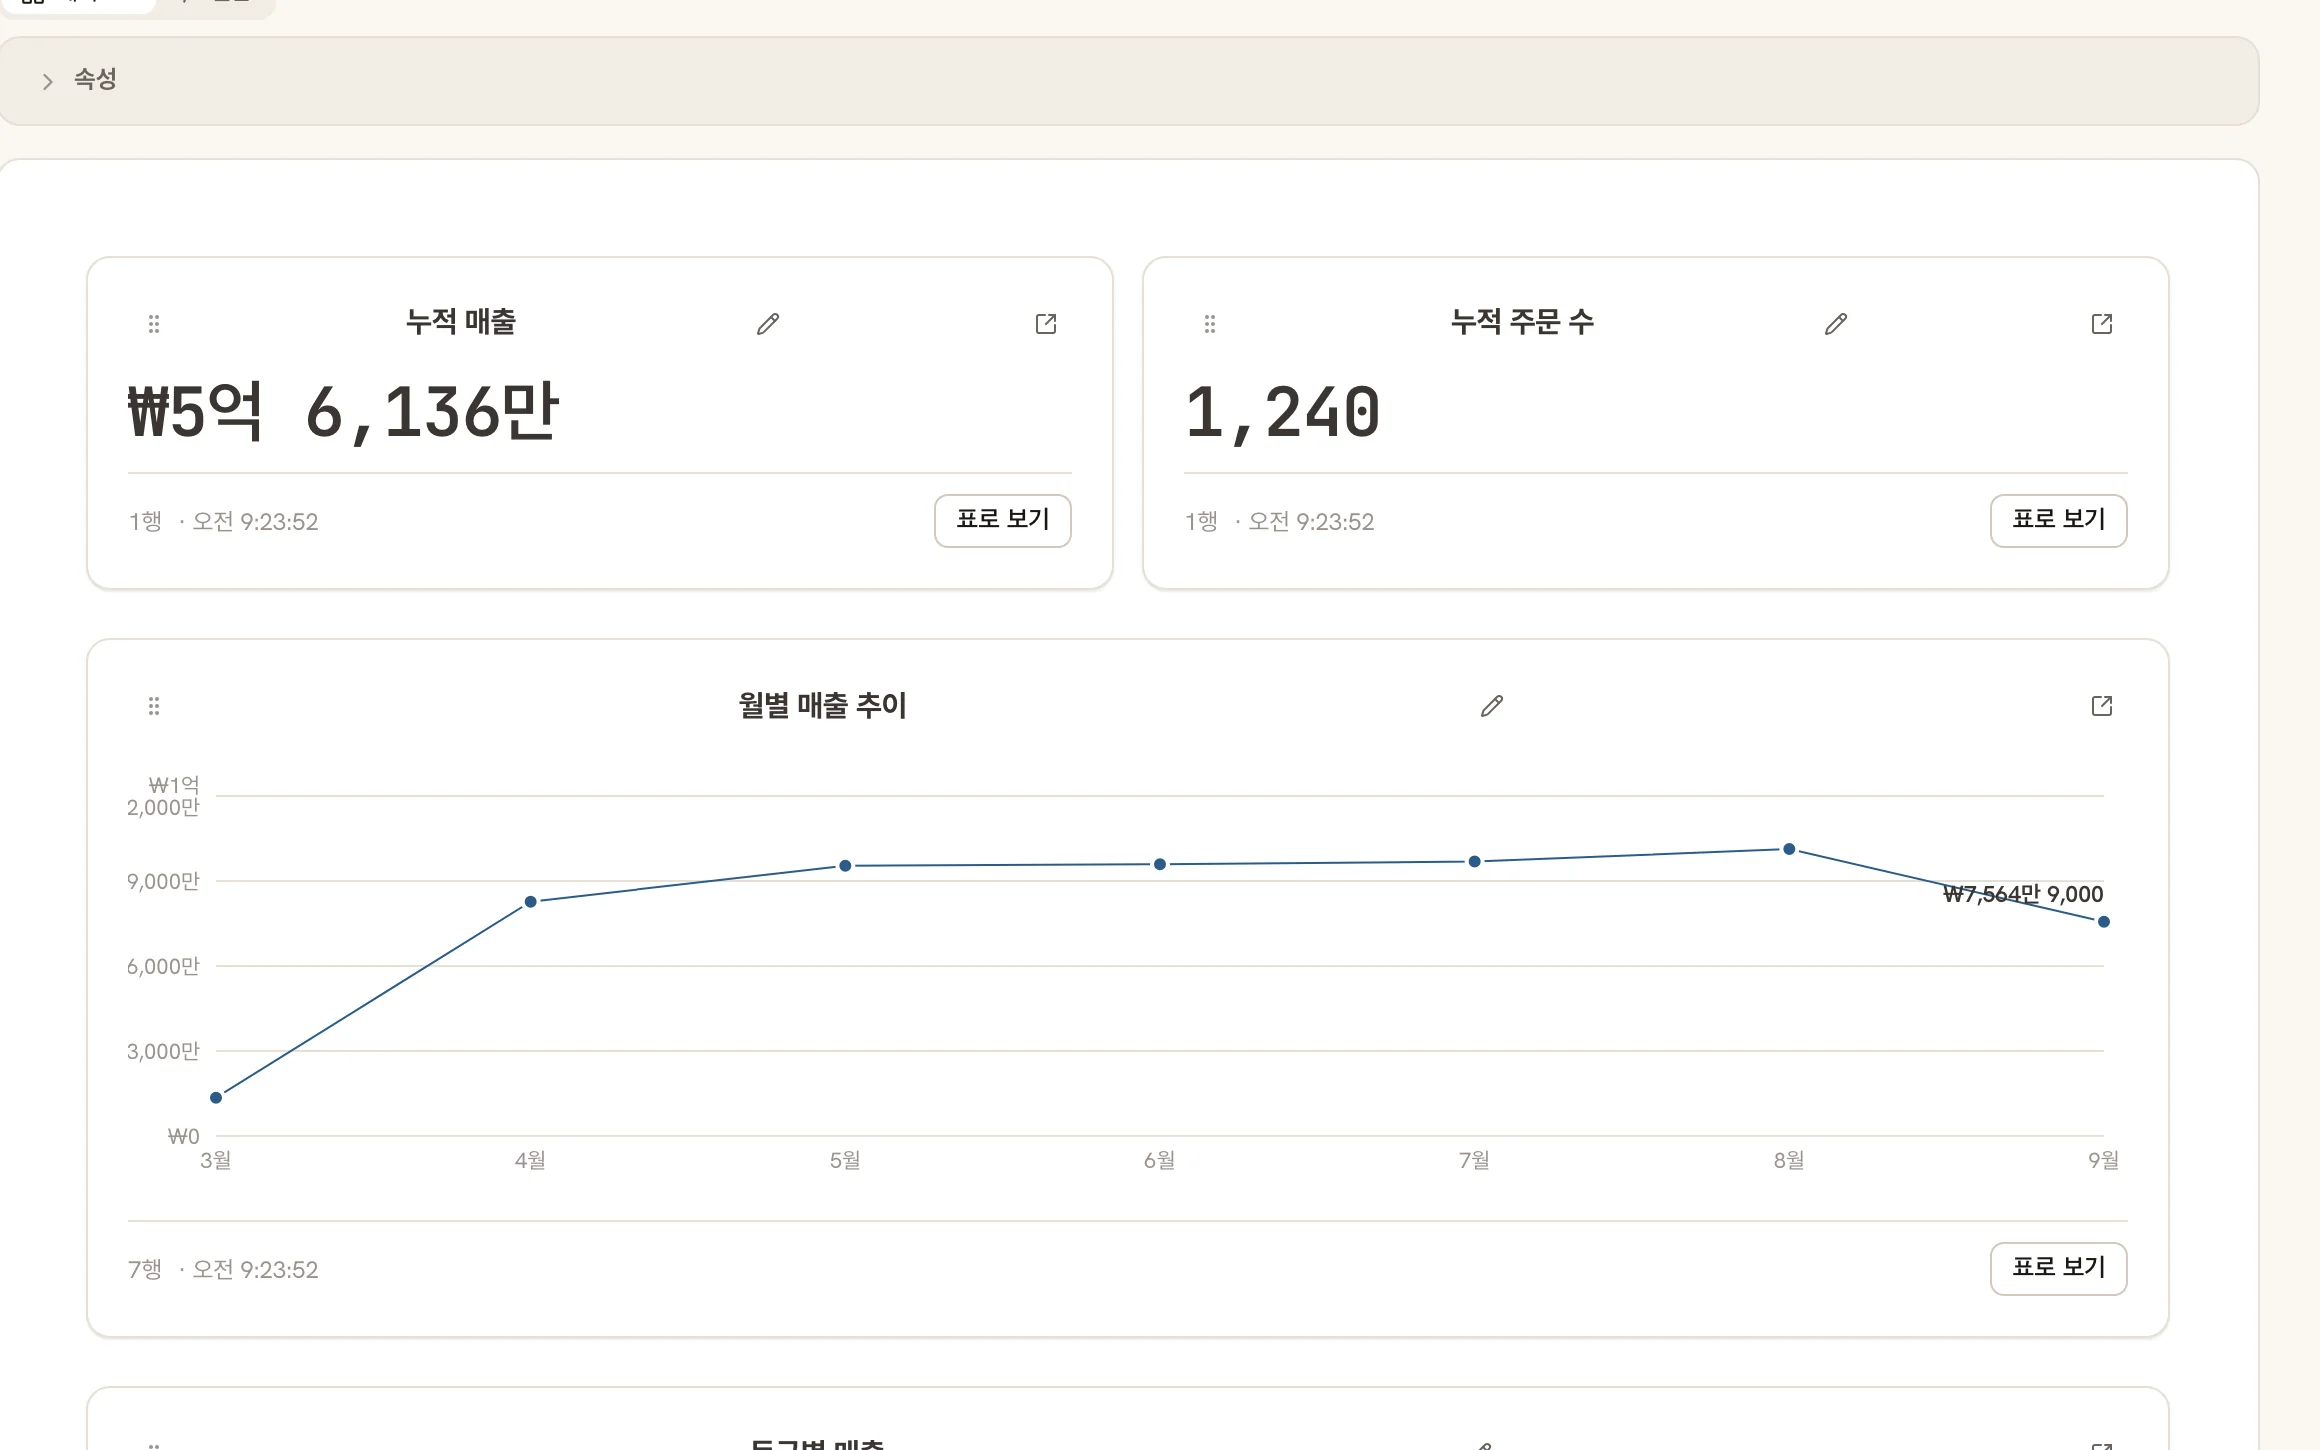
같은 데이터를 KPI·추이·비교·비중 카드로 배치한 대시보드 문서. 문서 하나가 곧 대시보드가 됩니다.
배치·가상화·실시간·LLM 서빙은 아래 플랫폼이 받고 권한과 정책은 그대로 내려갑니다. 누가 무엇을 볼 수 있는지는 바뀌지 않습니다. PAASUP DIP 보기
데이터 소스 하나와 문서 저장소 하나를 고릅니다.
고른 범위에서 같은 질문을 두 권한으로 실행해 봅니다. 그것으로 PoC가 끝납니다.
소스와 저장소를 필요한 만큼 더합니다. 권한과 정책은 같은 방식으로 따라옵니다.
더 구체적인 조건은 상담에서 환경에 맞춰 정리해 드립니다.
자주 묻는 질문과 그 답이 있는 문서·데이터 위치를 알려주시면 PoC 범위를 정리해 회신합니다.